GPT-6 Sol 发布一周后,GPT-6.1 Sol 就紧接着上线了。我更新 Codex 后,模型选择器里自动出现了新版本。实际吸引我切换的原因很直接:标准输入和输出价格没有上涨,但能力进一步接近 GPT-6 Astra。
微信扫码咨询 GPT-6.1 Sol 使用入口、Codex 额度与 Plus/Pro 套餐选择
微信扫码添加客服,备注 gpt
如果你正在搜索“GPT-6.1 Sol 怎么用”,可以先记住结论:它已经在 ChatGPT Work、Codex 和 API 中开放,适合接手日常软件开发、电脑操作、复杂 PDF 分析和多工具工作流;普通 Chat 暂时没有提供。
相关教程:
- 想先了解上一代定位?查看 GPT-6 Sol、Luna 与 Astra 的价格和性能对比
- 担心 Codex 用量不够?查看 GPT-6 额度、查询与重置规则
- 不确定推理强度怎么选?查看 GPT-6 Astra 推理等级与省 Token 设置
- 需要查询剩余额度?查看 Codex Plus/Pro 额度与查询方法
GPT-6.1 Sol 发布了什么?
GPT-6.1 Sol 不是一次只改名称的小更新。它继续保持 Sol 的速度和价格定位,同时重点提升长程软件工程、电脑操作、复杂文档理解与多工具 Agent 工作流表现。
| 项目 | GPT-6.1 Sol 信息 |
|---|---|
| 开放入口 | ChatGPT Work、Codex、OpenAI API |
| 覆盖套餐 | Plus、Pro、Business、Enterprise、Edu |
| 普通 Chat | 暂未提供 |
| API 模型 ID | gpt-6.1-sol |
| 同场更新 | Ultrafast 版本、每月 500 美元的新 Pro 档位 |
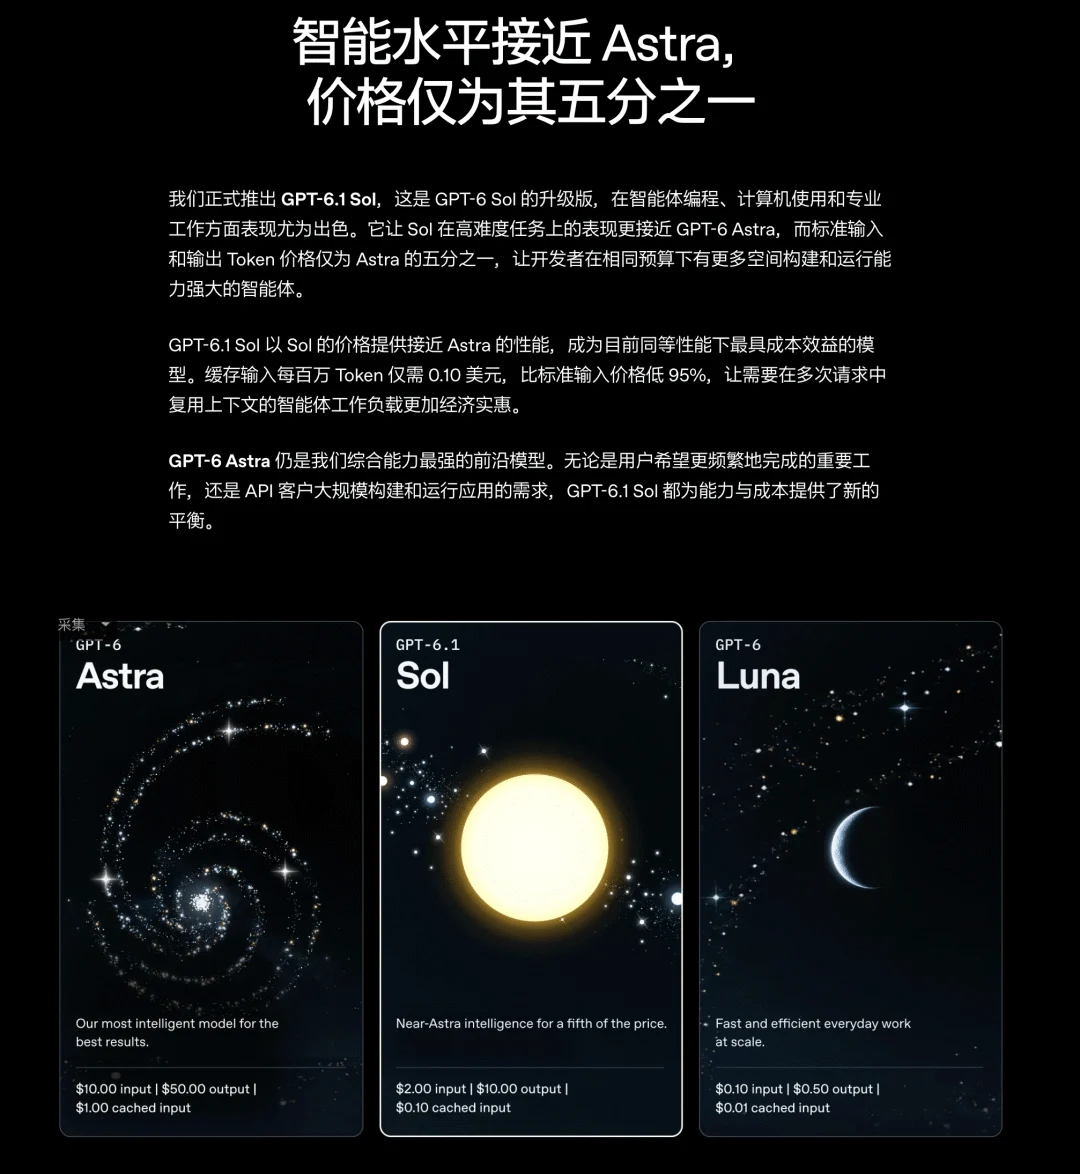 GPT-6.1 Sol 的产品定位、开放入口与 API 价格
这次升级的核心不是让 Sol 完全取代 Astra,而是把更多接近旗舰模型的执行能力放到成本更低的常用档位。对于经常遇到 Plus 或 Pro 5x 额度不够用的人,这个变化比单纯提高榜单分数更实用。
GPT-6.1 Sol 编程和电脑操作能力提升多少?
参考稿使用 DeepSWE v1.1 和 OSWorld 2.0 观察 GPT-6.1 Sol 的实际执行能力。这两项评测分别对应复杂软件工程与电脑操作,和 Codex 用户的日常工作比较接近。
DeepSWE:复杂软件工程任务
DeepSWE v1.1 使用新编写的任务,覆盖多个代码仓库和编程语言,并通过验证器检查最终软件行为。题目不只要求写一个函数,还可能要求模型增加配置文件解析、处理服务关闭时尚未完成的请求,并同步修改调用处与测试。
GPT-6.1 Sol 以约五分之一的单任务成本,达到与 Astra 相当的水平;在更低的推理强度下,它比 GPT-6 Sol 的最高得分高出 6.4 个百分点。
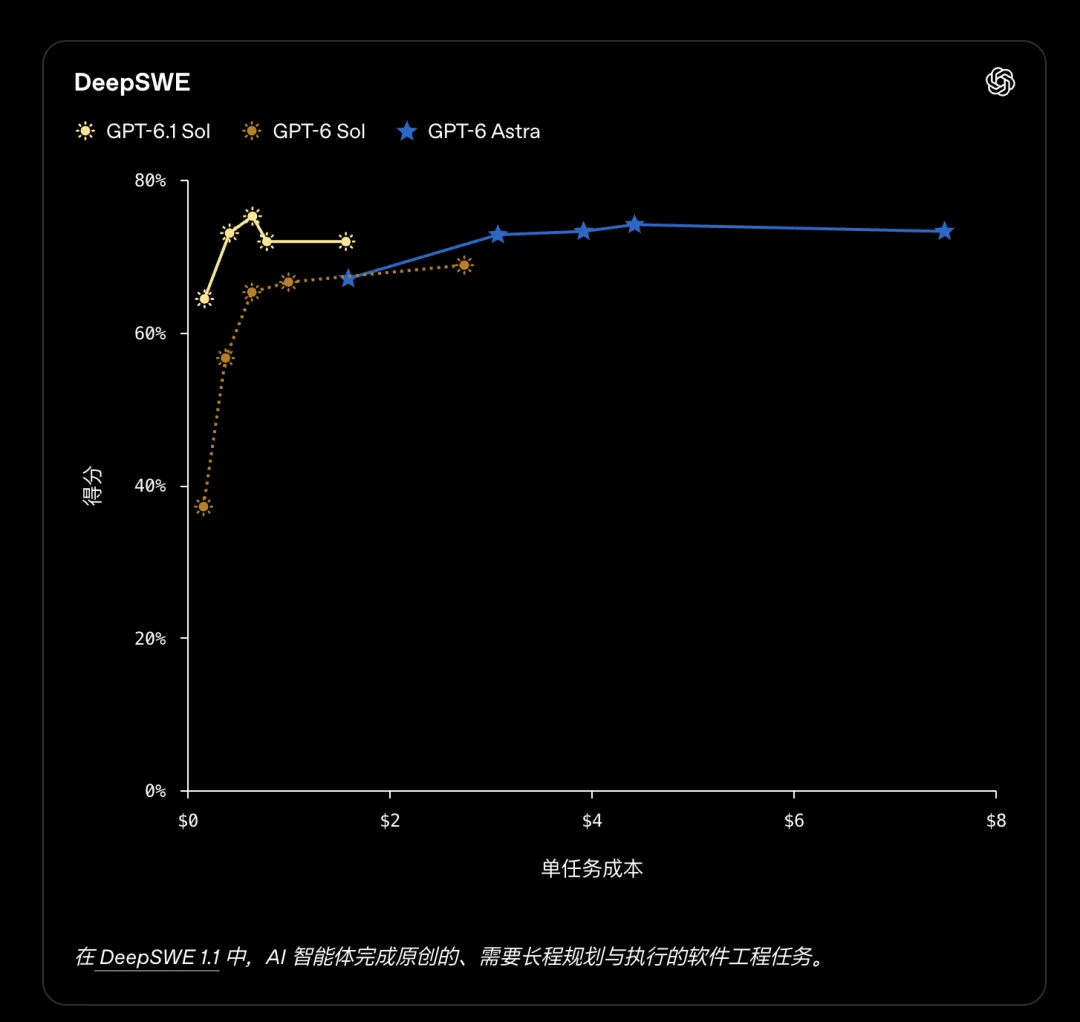 GPT-6.1 Sol、GPT-6 Sol 与 Astra 的 DeepSWE 软件工程评测结果
这类结果最适合用来判断模型能否接手完整项目任务。代码写完以后,它还要继续检查引用位置、补测试并确认旧行为没有被破坏。项目越大,这些收尾步骤越容易影响最终交付质量。
OSWorld 2.0:电脑操作任务
在 OSWorld 2.0 v2026.08.08 离线集的最高推理档位下,GPT-6.1 Sol 比 GPT-6 Sol 高 7 个百分点,单任务成本不到一半;它与 Astra 的差距缩小到 2.1 个百分点,成本约为 Astra 的七分之一。
对开发者来说,这意味着模型改完网页代码后,可以继续打开浏览器检查按钮、排版和页面状态,再返回代码修复问题。单元测试能核对逻辑,浏览器截图则能暴露文字太小、镜头太远或布局错位等视觉问题,两种检查连起来才是一条完整工作流。
GPT-6.1 Sol 的 PDF 和多工具评测表现
除了编程,GPT-6.1 Sol 还针对复杂文档和跨工具任务做了增强。
GDP.pdf:复杂 PDF 理解
GDP.pdf 要求模型根据复杂 PDF 回答真实工作问题,材料中包含表格、图表和小字号细节。OpenAI 报告显示,GPT-6.1 Sol 在受测推理档位下的得分都高于带回退机制的 Claude Opus 5.5,单任务成本不到后者的一半。
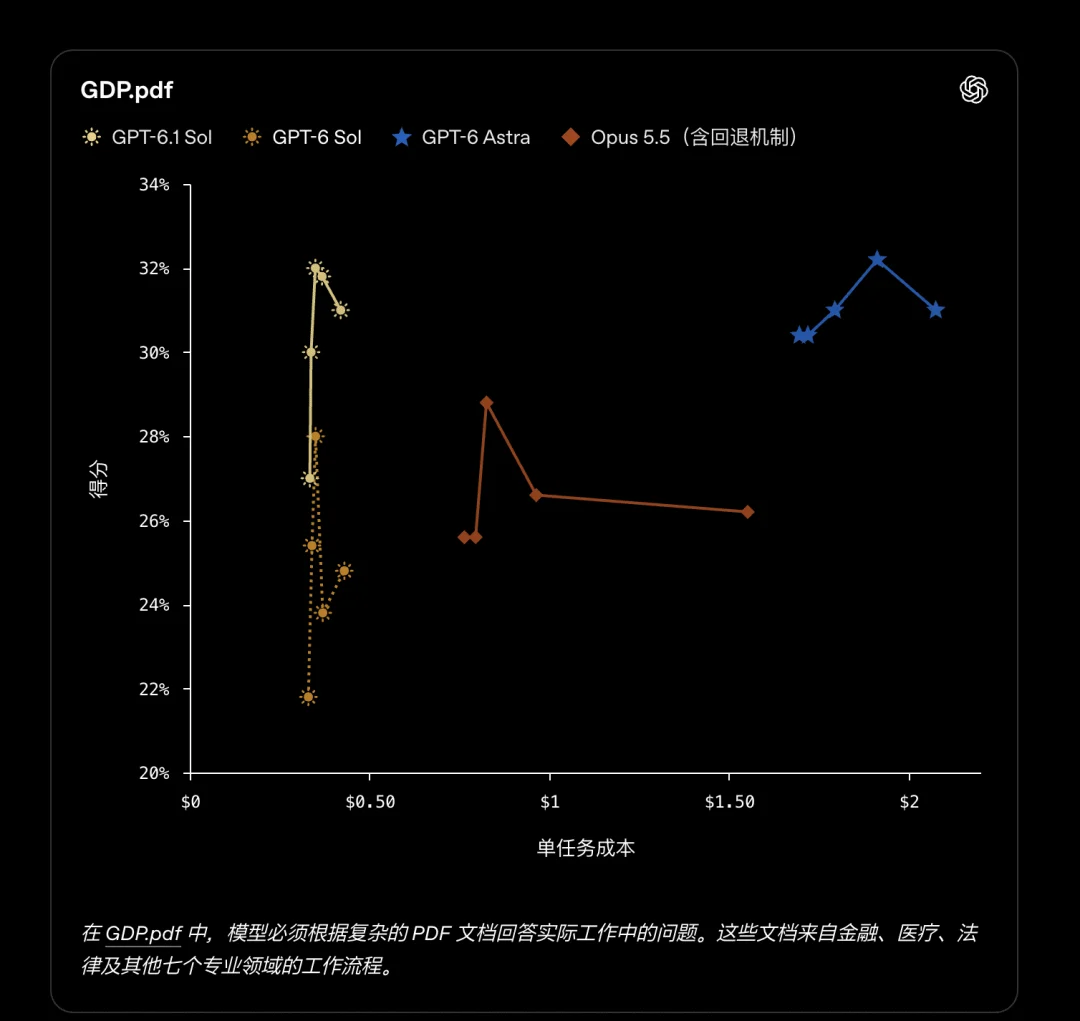 GPT-6.1 Sol 与 Claude Opus 5.5 的 GDP.pdf 复杂文档评测结果
这项能力适合财报、研究报告、产品说明书和长篇合同等场景。模型不仅要找到文字,还要正确读取表格关系和图表中的细节。
AutomationBench:多工具工作流
AutomationBench 让 Agent 调用销售、运营和财务等领域的工具,完成连续多步骤任务。评测图中同时保留了回退机制说明,因此比较结果和成本时,需要把模型是否调用回退一起考虑。
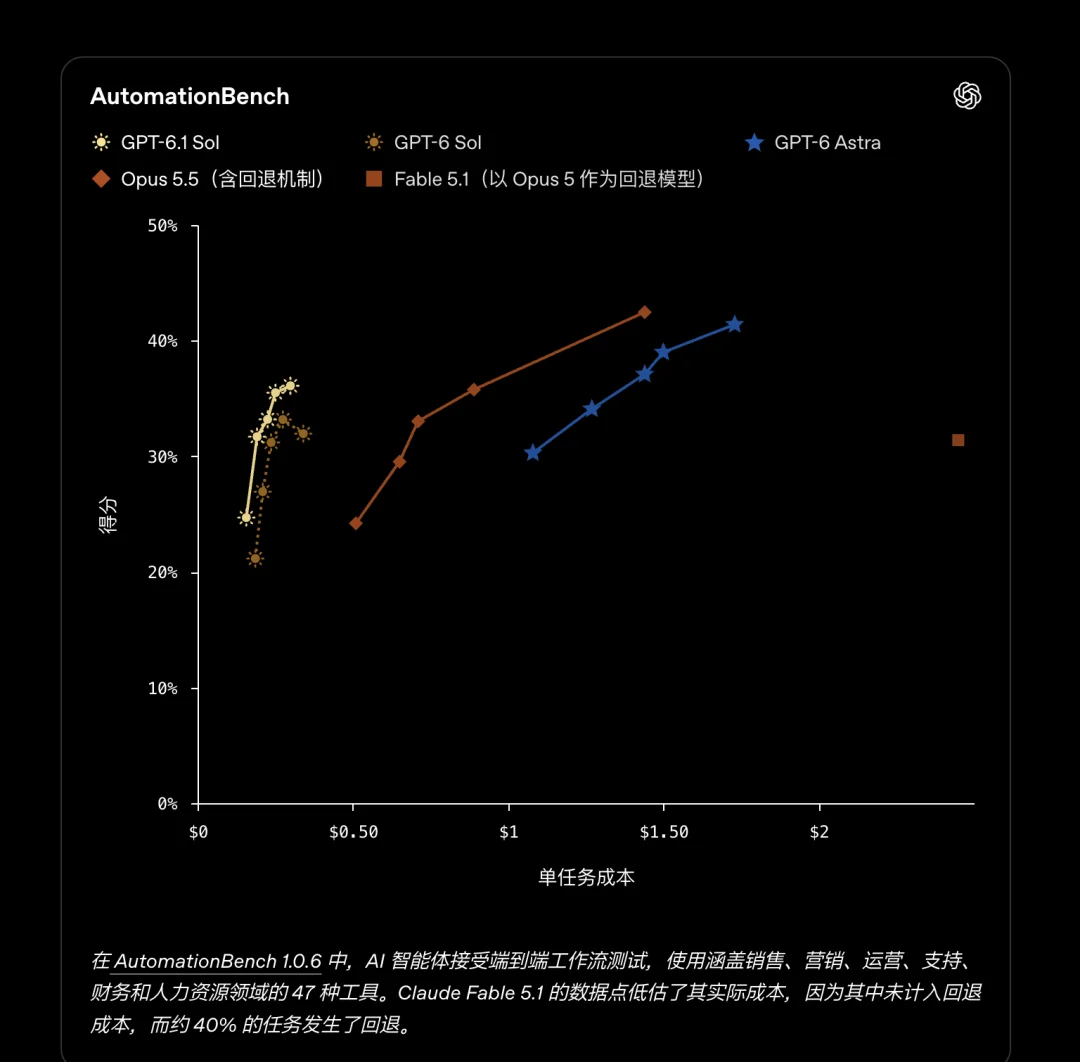 GPT-6.1 Sol 在 AutomationBench 多工具 Agent 工作流中的表现
对真实业务而言,重点不是模型能否答对一个问题,而是它能否读取资料、调用工具、处理返回结果并继续完成后续步骤。GPT-6.1 Sol 的定位正是把这种长链路执行能力带到日常主力模型中。
GPT-6.1 Sol 与 GPT-6 Sol、Astra 有什么区别?
独立评测中的综合能力指数显示,GPT-6.1 Sol 比 GPT-6 Sol 高 4 分,距离 Astra 只差 1 分。在 max 档位下,GPT-6.1 Sol 的平均单任务成本为 0.72 美元,Astra 为 3.26 美元。
| 对比维度 | GPT-6 Sol | GPT-6.1 Sol | GPT-6 Astra |
|---|---|---|---|
| 定位 | 日常高性价比执行 | 能力更接近 Astra 的主力执行模型 | 高难度旗舰任务 |
| 综合能力指数 | 作为基准 | 比 GPT-6 Sol 高 4 分 | 比 GPT-6.1 Sol 高 1 分 |
| 编程 Agent | 旧版 Sol 水平 | xhigh 表现突出 | 复杂任务能力上限更高 |
| 使用成本 | 较低 | 标准输入输出价格不变 | 单任务成本更高 |
| 更适合的任务 | 常规编程与执行 | 长程开发、电脑操作、多工具工作流 | 结果要求最高的关键任务 |
编程智能体指数还出现了一个值得注意的结果:GPT-6.1 Sol 的 xhigh 得分比自身 max 高 3 分,同时比 Astra 高 1 分。这说明推理预算并非越高越好,应该先在自己常做的任务上比较结果,再决定是否提高档位。
如果你还需要对比 Luna 的低成本批量任务定位,可以继续查看 GPT-6 Sol、Luna 和 Astra 怎么选。
GPT-6.1 Sol API 价格和缓存怎么算?
GPT-6.1 Sol 的标准 API 价格为每百万输入 Token 2 美元、每百万输出 Token 10 美元;缓存读取为每百万 Token 0.10 美元,相当于普通输入价格的 5%。
| 计费项目 | 每百万 Token 价格 |
|---|---|
| 标准输入 | 2 美元 |
| 缓存读取 | 0.10 美元 |
| 缓存写入 | 2.50 美元 |
| 标准输出 | 10 美元 |
缓存适合反复读取相同项目规则和历史上下文的 Agent 任务。可复用的内容越多,长任务越容易从缓存折扣中受益。但缓存写入另行计费,不能把所有上下文都按 0.10 美元估算。
当输入超过 272K Token 时,整个请求的输入和缓存费率会翻倍,输出费率变为 1.5 倍。核算长上下文任务时,还要把失败重试、额外工具调用和人工返工算进去。一次任务少返工一轮,对总成本的影响可能不低于缓存降价。
升级 Plus 或 Pro,在 Codex 与 ChatGPT Work 中体验 GPT-6.1 Sol
GPT-6.1 Sol 怎么在 Codex、Work 和 API 中使用?
GPT-6.1 Sol 已覆盖 ChatGPT Work、Codex 和 API,但普通聊天暂未提供。如果你使用的是 Codex,可以按下面的顺序检查:
- 更新 Codex 到当前可用版本;
- 确认登录的是符合条件的 Plus、Pro、Business、Enterprise 或 Edu 账号;
- 打开模型与推理强度选择器;
- 选择
GPT-6.1 Sol; - 从熟悉且容易验收的项目任务开始测试。
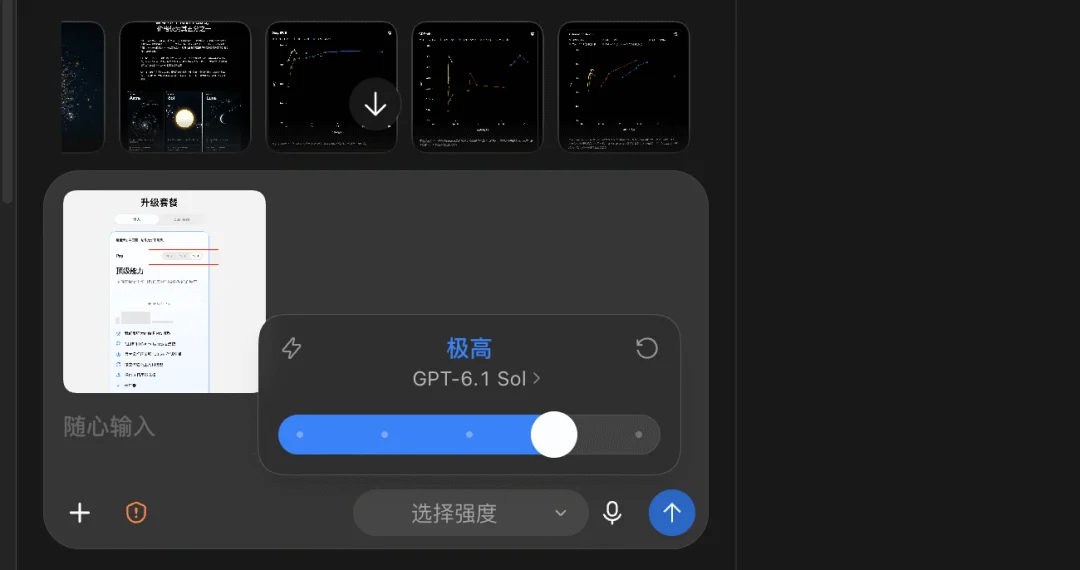 Codex 中选择 GPT-6.1 Sol 模型与推理强度
API 用户则使用模型 ID:
gpt-6.1-sol
建议第一次测试时固定需求、代码仓库和验收标准,观察模型是否会自行运行测试、检查界面并修正问题,同时记录完成时间、Token 消耗和人工修改量。这样比只看一次对话的答案更容易判断是否值得迁移。
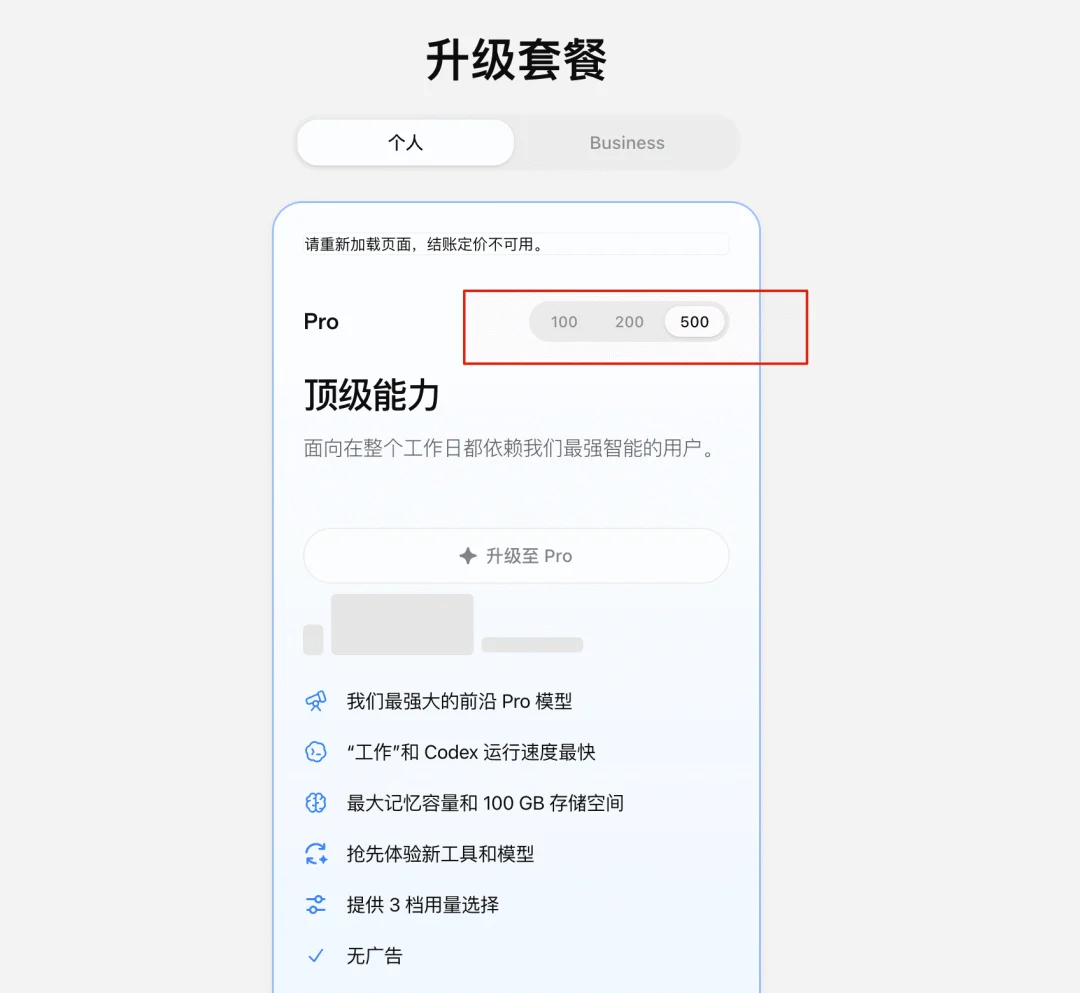 ChatGPT Pro 新套餐档位与 GPT-6.1 Sol 使用权益
如果模型已经可见但任务很快触发限制,可以参考 GPT-6 额度的五小时、每周周期与重置方法;需要查看具体剩余量时,再使用 Codex 网页端和 CLI 额度查询方法。
GPT-6.1 Sol 推理档位怎么选?
独立评测观察到,GPT-6.1 Sol 在不同 Intelligence Index 档位下,比 GPT-6 Sol 多使用约 10%~30% 的输出 Token。能力提高和输出变长可能同时发生,因此更换模型后需要一起比较结果质量、等待时间和 Token 消耗。
我更倾向于这样选择:
| 使用场景 | 建议档位 |
|---|---|
| 需求明确、改动范围较小 | 从中低档位开始 |
| 多文件开发、需要运行测试 | 优先比较 high 与 xhigh |
| 长程软件工程或复杂电脑操作 | 使用 xhigh,观察实际交付质量 |
| 关键任务仍无法完成 | 再尝试 max 或改用 Astra |
不要仅凭“最高档”三个字做决定。先用一个熟悉项目测试模型能否自行运行、检查和修正,再记录整次任务账单。如果 GPT-6.1 Sol 能稳定完成这些步骤,就让它承担日常开发;难度更高或结果要求更严的任务继续交给 Astra。
GPT-6.1 Sol 常见问题
GPT-6.1 Sol 已经正式发布了吗?
已经发布,并在 ChatGPT Work、Codex 和 API 中开放。覆盖 Plus、Pro、Business、Enterprise 与 Edu 用户,普通 Chat 暂未提供。
GPT-6.1 Sol 的 API 模型 ID 是什么?
API 模型 ID 是 gpt-6.1-sol。标准价格为每百万输入 Token 2 美元、输出 Token 10 美元,缓存读取为 0.10 美元。
GPT-6.1 Sol 比 GPT-6 Sol 强多少?
参考稿中的独立综合能力指数显示,GPT-6.1 Sol 比 GPT-6 Sol 高 4 分;在 DeepSWE 中,它使用更低推理强度仍比 GPT-6 Sol 的最高得分高 6.4 个百分点。具体收益仍取决于任务类型和推理档位。
GPT-6.1 Sol 可以在普通 ChatGPT 对话中使用吗?
暂时不可以。当前入口是 ChatGPT Work、Codex 和 API,普通 Chat 尚未提供 GPT-6.1 Sol。
GPT-6.1 Sol 应该选 xhigh 还是 max?
可以先测试 xhigh。参考稿中的编程智能体指数里,GPT-6.1 Sol 的 xhigh 得分比自身 max 高 3 分。遇到无法完成的高难度任务时,再增加推理预算或切换 Astra。
选择建议:GPT-6.1 Sol 更适合作为新的日常开发与 Agent 主力模型,Astra 继续负责能力上限和关键交付。真正值得记录的不是单次回答价格,而是模型完成整条工作流需要多少时间、Token、重试和人工修改。
延伸阅读: